
Ordenación dentro de la ventana
En los artículos anteriores vimos las funciones de ventana y las particiones en SQL. Ahora pasemos a otra característica importante de las funciones de ventana: la ordenación dentro de la ventana.
¿Para qué sirve ordenar dentro de la ventana?
La ordenación en las funciones de ventana de SQL es la clave para un análisis de datos más avanzado. Permite ordenar los datos dentro de un grupo o ventana concretos y conseguir así cálculos agregados más precisos y específicos. Resulta especialmente útil al trabajar con series temporales, donde importa el orden de los acontecimientos, o al clasificar datos dentro de grupos.
Ejemplo de uso
Planteamiento del problema
Supongamos que tenemos que analizar los datos de reservas de alojamientos para averiguar cómo ha ido cambiando con el tiempo el importe total que cada usuario ha gastado en alquileres.
Inicialmente tenemos estos datos de reservas:
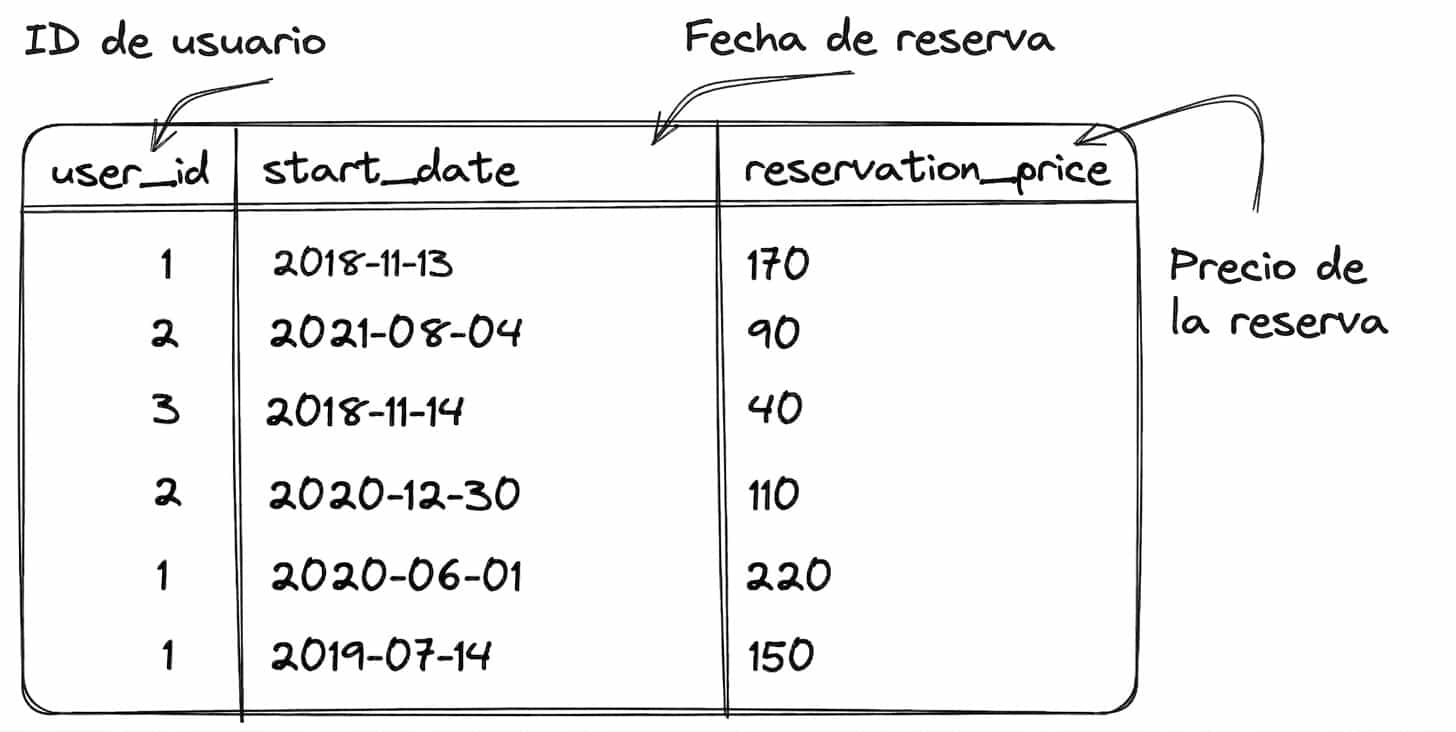
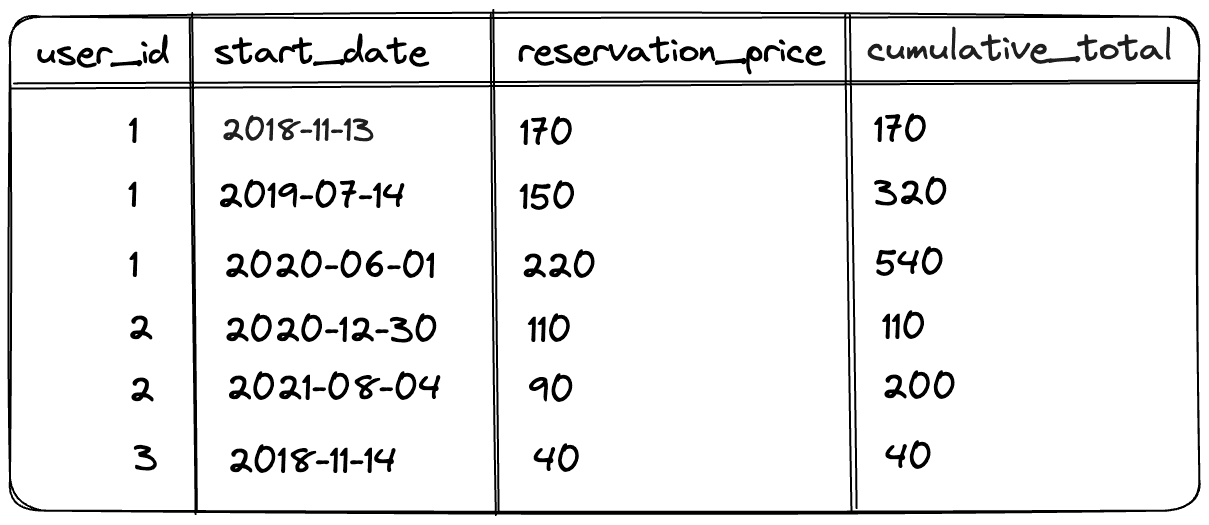
Y como resultado queremos ver cómo evoluciona el gasto de cada usuario a lo largo del tiempo, es decir, una tabla como esta:
Dividir los datos en particiones
Para obtener el resultado que buscamos, lo primero es dividir los datos en particiones por usuario, de modo que la función de ventana trabaje para cada usuario de forma independiente. Para calcular la suma podemos usar la función de ventana SUM.
MySQL 8.4SELECT user_id,
       start_date,
       total AS reservation_price,
       SUM(total) OVER (
            PARTITION BY user_id
       ) AS total_expenses
FROM Reservations;
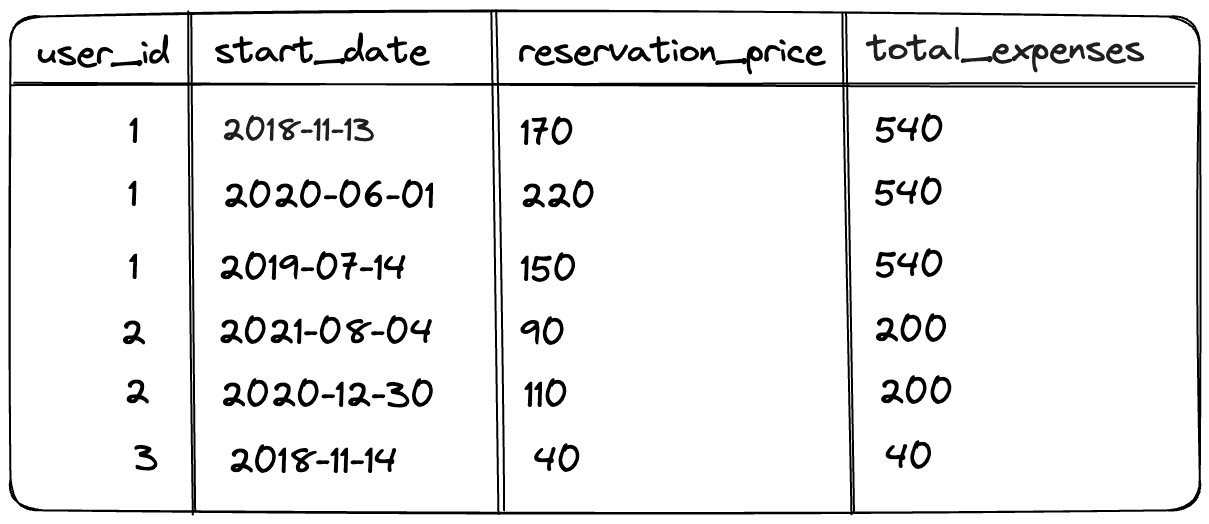
Tras ejecutar la consulta, la columna total_expenses muestra el importe total gastado por cada usuario. Pero no es exactamente lo que queremos: los datos de la tabla no están ordenados por fecha y no vemos cómo ha ido creciendo el gasto total con el tiempo, solo el gasto final.
Para conseguir el resultado deseado, tenemos que añadir a la consulta una ordenación por la fecha de inicio de la reserva:
MySQL 8.4SELECT user_id,
       start_date,
       total AS reservation_price,
       SUM(total) OVER (
           PARTITION BY user_id
           ORDER BY start_date
       ) AS cumulative_total
FROM Reservations;
Ahora tenemos justo lo que queríamos. Pero ¿qué ha cambiado al añadir ORDER BY start_date?
- Los datos dentro de cada partición están ordenados por la fecha de inicio de la reserva.
- Ha cambiado la forma de calcular el importe total gastado: ahora la suma se va acumulando dentro de la partición, en lugar de mostrarse como total final. Esto se debe a una particularidad de la ordenación cuando no se indica explícitamente ROWS|RANGE en la expresión OVER. Veámoslo con más detalle.
Particularidades de la ordenación sin indicar el marco de la ventana
Como recordarás, la sintaxis completa de una función de ventana es la siguiente:
SELECT funcion_ventana(campo_tabla)
OVER (
    [PARTITION BY columna_particion [, ...]]
    [ORDER BY columna_orden [, ...]]
    [{ROWS | RANGE} marco_ventana]
)- [ ]parte opcional
- { a | b }una de las opciones
- ...se puede repetir
- funcion_ventana
La función que se calcula sobre la ventana, por ejemplo AVG o SUM.
- campo_tabla
La columna cuyos valores se pasan a la función, por ejemplo price en AVG(price).
- columna_particion
Divide el resultado en particiones que no se solapan: en cada una entran las filas con los mismos valores en estas columnas.
Opcional- columna_orden
Define el orden de las filas dentro de la ventana. Es especialmente importante en las funciones de ventana de ranking.
Opcional- marco_ventana
Define el marco de la ventana: cuántas filas se toman antes y después de la fila actual.
Opcional
Además de PARTITION BY y ORDER BY, contiene el bloque opcional ROWS|RANGE. Lo veremos en detalle en el siguiente artículo; ahora lo importante es para qué sirve. Permite indicar un marco de ventana respecto a la fila actual, que se usará para el cálculo en la función de ventana.
Por ejemplo, puedes indicar que, al calcular los valores de la fila actual, a la función de ventana no lleguen todos los registros de la partición, sino solo N registros anteriores a la fila actual y N posteriores.
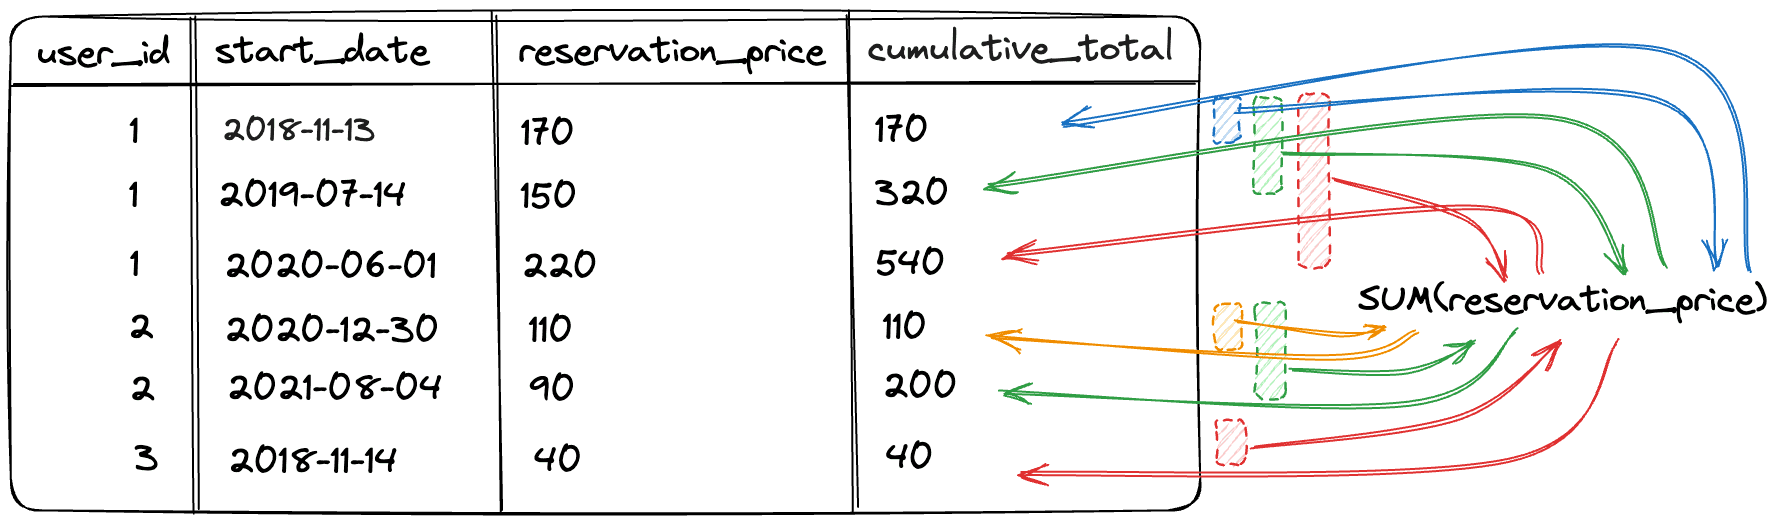
Si usas ORDER BY y no indicas nada en el bloque ROWS|RANGE, la función de ventana aplica automáticamente la regla RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW. Esto significa que el marco de la ventana empieza en la primera fila y termina en la fila actual, incluidas todas las filas que tienen los mismos valores en las columnas de ordenación que la fila actual.
Es decir, los valores de la columna cumulative_total se calculan así:
Encontrarás más información sobre los marcos de ventana y cómo definirlos en el siguiente artículo.