
Índices en SQL
Cuando añades una fila nueva a una tabla, el SGBD no coloca los datos de forma óptima. Por ejemplo, si añades una fila a la tabla Users, el SGBD no ordena las filas por los valores de la columna id ni alfabéticamente por last_name. En su lugar, simplemente coloca los datos en el siguiente hueco libre del archivo (el SGBD mantiene una lista de espacios libres para cada tabla).
Por eso, para ejecutar una consulta como esta:
MySQL 8.4SELECT email FROM Users WHERE email LIKE 'l%';
el servidor de base de datos tiene que revisar cada fila de la tabla para encontrar las coincidencias. Con tablas pequeñas no pasa nada, pero a medida que crece el volumen de datos se vuelve demasiado lento.
Para comparar, así se comporta una búsqueda por email con y sin índice en la columna:
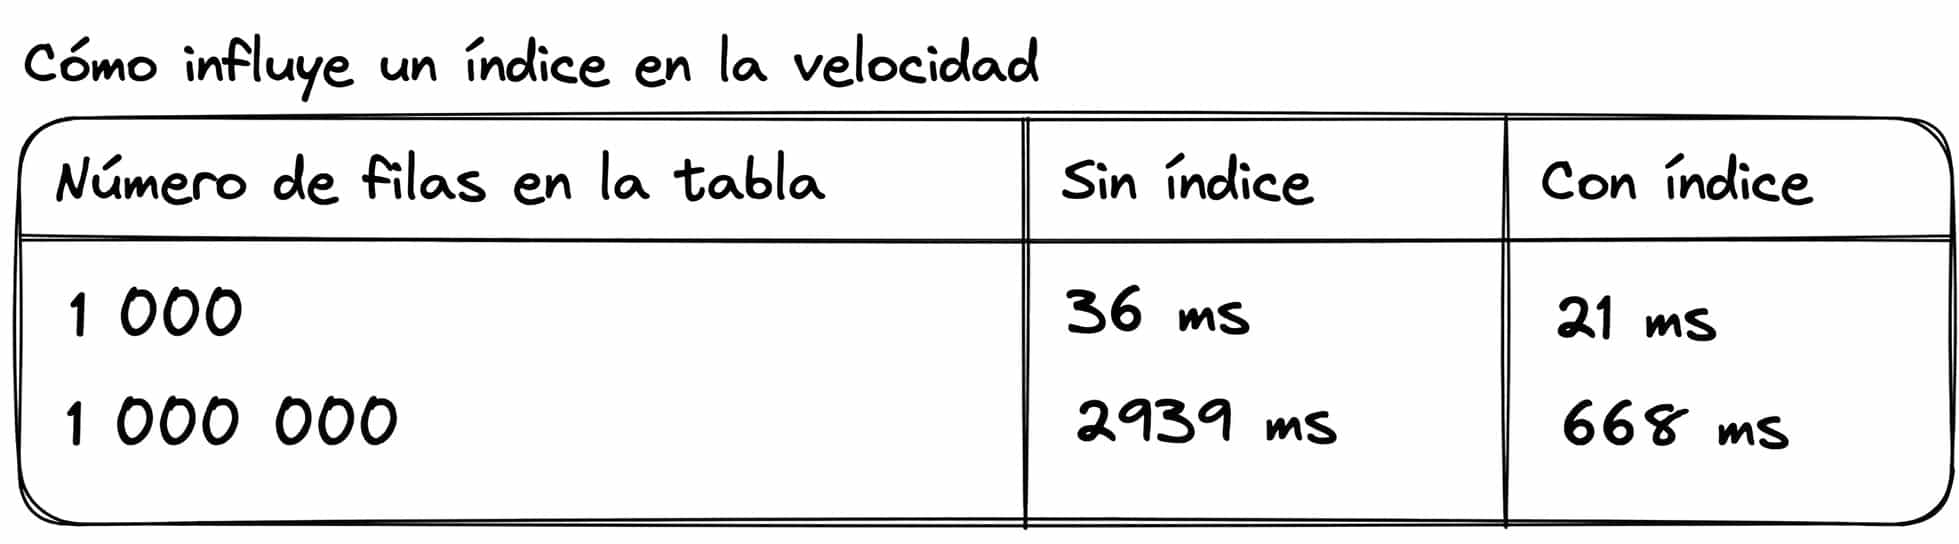
Los índices funcionan como el índice alfabético de un libro 📖: te permiten encontrar la información rápidamente sin leer todo el texto. Son tablas especiales cuyas filas, a diferencia de las tablas de datos normales, están en un orden estrictamente definido. Pero, en lugar de contener todos los datos de un registro, un índice guarda solo la columna (o columnas) por la que se busca, junto con la información de dónde está físicamente esa fila. Así, los índices sirven para encontrar un subconjunto de filas y columnas sin tener que recorrer cada fila de la tabla.
Crear un índice ✨
Volviendo a la tabla Users, puedes añadir un índice a la columna email para acelerar cualquier consulta que trabaje con los valores de esa columna.
Así se añade un índice de este tipo en MySQL:
MySQL 8.4CREATE INDEX idx_email
    ON Users (email);
Esta sentencia crea un índice llamado idx_email para la columna Users.email. Si el índice existe, el optimizador de consultas puede decidir usarlo cuando le resulte útil. Si una tabla tiene más de un índice, el optimizador decide cuál conviene más para cada sentencia SQL concreta.
Todos los sistemas de gestión de bases de datos permiten ver los índices existentes. En MySQL existe el comando SHOW, que muestra todos los índices de una tabla:
MySQL 8.4SHOW INDEX FROM Users;
El resultado muestra que la tabla Users tiene dos índices: uno para la columna id, llamado PRIMARY, y otro para la columna email, que acabamos de crear.
Al crear la tabla, MySQL generó automáticamente un índice para la columna de la clave primaria (en este caso, id) y le dio el nombre PRIMARY. Es un tipo especial de índice que va asociado a la restricción de clave primaria y garantiza que cada valor de la columna (o grupo de columnas) sea único y no pueda ser NULL.
Así se añade un índice de este tipo en PostgreSQL:
MySQL 8.4CREATE INDEX idx_email
    ON Users (email);
Esta sentencia crea un índice llamado idx_email para la columna Users.email. Si el índice existe, el optimizador de consultas puede decidir usarlo cuando le resulte útil. Si una tabla tiene más de un índice, el optimizador decide cuál conviene más para cada sentencia SQL concreta.
Todos los sistemas de gestión de bases de datos permiten ver los índices existentes. En PostgreSQL puedes consultar las tablas del sistema para ver todos los índices de una tabla:
MySQL 8.4SELECT indexname, indexdef
FROM pg_indexes
WHERE tablename = 'users';
PostgreSQL crea automáticamente un índice para la columna de la clave primaria (en este caso, id). Es un tipo especial de índice que va asociado a la restricción de clave primaria y garantiza que cada valor de la columna (o grupo de columnas) sea único y no pueda ser NULL.
PostgreSQL admite distintos tipos de índices:
- B-Tree (por defecto): para operaciones de comparación y ordenación
- Hash: para comparaciones de igualdad
- GIN: para valores compuestos (arrays, JSON)
- GiST: para datos geométricos y búsqueda de texto completo
- BRIN: para tablas muy grandes con un orden natural
Eliminar un índice
Si después de crear un índice decides que ya no lo necesitas, puedes eliminarlo así:
MySQL 8.4DROP INDEX idx_email ON Users;
Si después de crear un índice decides que ya no lo necesitas, puedes eliminarlo así:
MySQL 8.4DROP INDEX idx_email;
Índices únicos (UNIQUE)
Al diseñar una base de datos es importante decidir en qué columnas se permiten valores repetidos y en cuáles no.
Por ejemplo, en la tabla Users puede haber varios usuarios con el mismo nombre, pero sus identificadores y direcciones de correo electrónico deben ser distintos para poder diferenciarlos.
Puedes garantizar la unicidad de los valores creando un índice único en la columna Users.email. Un índice único cumple dos funciones:
- ofrece todas las ventajas de un índice normal
- impide que haya valores duplicados en la columna indexada
El SGBD comprueba el índice único cada vez que se intenta insertar o modificar datos en la columna indexada, para asegurarse de que el nuevo valor no existe ya en la tabla.
Un índice único para la columna Users.email se crea así:
MySQL 8.4CREATE UNIQUE INDEX idx_email
    ON Users (email);
Con este índice, si intentas añadir un cliente nuevo con una dirección de correo que ya existe, recibirás un mensaje de error:
MySQL 8.4Error(1062) 23000: "Duplicate entry 'duplicate@gmail.com' for key 'users.idx_email'"
Con este índice, si intentas añadir un cliente nuevo con una dirección de correo que ya existe, recibirás un mensaje de error:
MySQL 8.4ERROR: duplicate key value violates unique constraint "idx_email"
DETAIL: Key (email)=(duplicate@gmail.com) already exists.
Crear índices únicos para la columna o columnas de la clave primaria es innecesario, porque el SGBD ya garantiza automáticamente la unicidad de los valores de la clave primaria. Aun así, tener varios índices únicos en una misma tabla está permitido y puede tener sentido si lo ves necesario.
Índices de varias columnas
Además de los índices de una sola columna, también puedes crear índices que abarquen varias columnas. Por ejemplo, para buscar estudiantes por nombre y apellido, puedes crear un índice conjunto sobre esas dos columnas:
MySQL 8.4CREATE INDEX idx_full_name
    ON Student (last_name, first_name);
Un índice así es útil para consultas en las que se usan tanto el nombre como el apellido, o solo el apellido. En cambio, no sirve de nada para consultas que solo filtran por el nombre. Es como buscar un número de teléfono en una guía telefónica: si conoces el nombre y el apellido, la búsqueda es fácil gracias a que la guía está ordenada por apellido y después por nombre. Si solo conoces el nombre, tendrás que revisar todas las entradas.
Al crear índices de varias columnas, es importante pensar bien el orden de las columnas para que el índice sea lo más eficiente posible. Aun así, siempre puedes crear varios índices con las mismas columnas en distinto orden si ciertas consultas lo necesitan.
Cómo se usan los índices
El SGBD suele utilizar los índices para encontrar rápidamente las filas buscadas y, después, obtener datos adicionales de tablas relacionadas si la consulta lo requiere. Tomemos como ejemplo esta consulta:
MySQL 8.4SELECT id, first_name, last_name
  FROM Student
  WHERE first_name LIKE 'A%' AND last_name LIKE 'L%'
Ante una consulta así, el SGBD puede elegir entre varias estrategias:
- Recorrer toda la tabla fila por fila.
- Usar el índice de last_name para encontrar a los estudiantes cuyo apellido empieza por «L» y luego comprobar en cada una de esas filas si el nombre empieza por «A».
- Usar el índice compuesto de last_name y first_name para encontrar directamente a los estudiantes que cumplen ambos criterios.
La última opción es la más eficiente: encuentra todas las filas necesarias en una sola pasada, sin tener que volver a la tabla.
¿Cómo saber qué método elegirá el optimizador de consultas de MySQL? Para eso existe el comando EXPLAIN, que muestra cómo planea el SGBD ejecutar la consulta sin llegar a ejecutarla:
MySQL 8.4EXPLAIN
  SELECT id, first_name, last_name
  FROM Student
  WHERE first_name LIKE 'A%'
  AND last_name LIKE 'L%';
En la columna possible_keys se ve que los índices aplicables son idx_last_name o idx_full_name, y en la columna key se indica que se ha elegido idx_full_name.
¿Cómo saber qué método elegirá el optimizador de consultas de PostgreSQL? Para eso existe el comando EXPLAIN, que muestra cómo planea el SGBD ejecutar la consulta:
MySQL 8.4EXPLAIN
  SELECT id, first_name, last_name
  FROM Student
  WHERE first_name LIKE 'A%'
  AND last_name LIKE 'L%';
También puedes usar EXPLAIN ANALYZE para obtener las estadísticas reales de ejecución:
MySQL 8.4EXPLAIN ANALYZE
  SELECT id, first_name, last_name
  FROM Student
  WHERE first_name LIKE 'A%'
  AND last_name LIKE 'L%';
En el resultado de EXPLAIN puedes ver qué método de acceso ha elegido el optimizador: un recorrido completo de la tabla (Seq Scan) o un recorrido del índice (Index Scan).
La otra cara de los índices
Si los índices son tan eficaces, ¿por qué no indexarlo todo? 🧐
La respuesta es que cada índice es en sí mismo una tabla (de un tipo especial, pero una tabla al fin y al cabo). Por eso, cada vez que se añade o se elimina una fila de la tabla, hay que actualizar todos sus índices. Al actualizar una fila, también hay que modificar todos los índices de las columnas afectadas. Cuantos más índices tengas, más trabajo tiene el SGBD para mantener al día todos los objetos del esquema, y más se ralentiza su funcionamiento.
Además, los índices ocupan espacio adicional en disco y requieren atención por parte de los administradores de bases de datos. Por eso, lo mejor es crear un índice solo cuando de verdad lo necesitas. Si solo lo necesitas temporalmente, por ejemplo para un informe mensual, puedes crearlo antes de empezar y eliminarlo al terminar.
En definitiva, se trata de encontrar el equilibrio: suficientes índices para que todo funcione con rapidez, pero no tantos que perjudiquen el rendimiento. Si no tienes claro cuántos índices necesitas, empieza con pocos y añade más según haga falta.
Comprobemos si has entendido el tema:
¿Qué afirmación explica mejor por qué no deberías indexar todas las columnas de una tabla?