
Normalización de bases de datos: 1FN, 2FN y 3FN con un solo ejemplo
La normalización consiste en llevar la estructura de una base de datos a una forma en la que cada hecho se guarda exactamente una vez. Sus reglas se describen por escalones, las formas normales: cada forma siguiente elimina su propio tipo de duplicación. En la práctica, en la inmensa mayoría de los casos bastan las tres primeras.
Vamos a ver las tres formas con un mismo ejemplo, que recorrerá el camino desde una «tabla cajón de sastre» hasta un esquema normalizado.
El punto de partida: todo en una tabla
Un servicio de comida a domicilio guarda sus pedidos así:
Parece compacta, pero así no hay quien trabaje:
- No se pueden contar las ventas de cola: los productos están pegados en una cadena y solo queda LIKE '%Cola%' y la esperanza de que nunca aparezca una «Cola Zero».
- Ana ha cambiado de teléfono: hay que actualizar todos sus pedidos. Si se te escapa una fila, la base de datos tendrá dos teléfonos distintos y ya no habrá forma de saber cuál es el bueno.
- Se ha borrado el pedido 2: con él ha desaparecido de la base de datos Boris junto con su teléfono.
- Un cliente nuevo sin pedidos: no hay dónde registrarlo.
Estas situaciones se llaman anomalías de modificación, de inserción y de borrado. La normalización existe precisamente para que no se produzcan.
1FN: un solo valor en cada celda
La primera forma normal exige atomicidad: en la intersección de una fila y una columna hay un único valor indivisible, sin listas ni enumeraciones. Desplegamos cada línea del pedido en una fila propia:
Ahora las ventas de cola se cuentan con un GROUP BY normal y corriente. Cada fila queda identificada de forma única por el par (order_id, product): es la clave compuesta de la tabla.
Pero la duplicación ha ido a más: el nombre y el teléfono de Ana se repiten en cada fila de cada uno de sus pedidos. Sigamos.
En una tabla de empleados hay una columna skills con valores del tipo 'SQL, Python, Excel'. ¿Qué regla de normalización se incumple?
2FN: un hecho depende de toda la clave, no de una parte
La segunda forma normal se fija en las tablas con clave compuesta y exige que cada columna no clave dependa de toda la clave (order_id, product), no de una parte de ella. Aquí hay dos infracciones:
- customer y phone dependen solo de order_id: quién ha hecho el pedido no cambia según el producto de la fila;
- price depende solo de product: el precio de la pizza es el mismo en todos los pedidos.
Llevamos cada hecho a una tabla en la que dependa de su clave completa:
MySQL 8.4CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    customer VARCHAR(100),
    phone VARCHAR(20)
);

CREATE TABLE products (
    product_id INT PRIMARY KEY,
    name VARCHAR(100),
    price DECIMAL(10,2)
);

CREATE TABLE order_items (
    order_id INT REFERENCES orders(order_id),
    product_id INT REFERENCES products(product_id),
    quantity INT,
    PRIMARY KEY (order_id, product_id)
);
Ahora el precio del producto se guarda una sola vez en products, y el contenido del pedido son pares compactos de identificadores en order_items.
3FN: las columnas no clave no dependen unas de otras
La tercera forma normal acaba con la última duplicación: las dependencias transitivas, en las que una columna no clave no depende de la clave, sino de otra columna no clave. En la tabla orders queda justo eso: phone depende de customer, no del número de pedido. El teléfono de Ana todavía se repite en cada uno de sus pedidos.
Llevamos el cliente a su propia tabla:
MySQL 8.4CREATE TABLE customers (
    customer_id INT PRIMARY KEY,
    name VARCHAR(100),
    phone VARCHAR(20)
);

CREATE TABLE orders (
    order_id INT PRIMARY KEY,
    customer_id INT REFERENCES customers(customer_id),
    order_date TIMESTAMP
);
Para recordar la esencia de la 3FN ayuda la fórmula clásica: cada columna no clave depende «de la clave, de toda la clave y de nada más que la clave».
Una tabla de pedidos tiene las columnas city y city_zip, y el código postal queda determinado de forma única por la ciudad. ¿Qué forma se incumple?
El esquema final
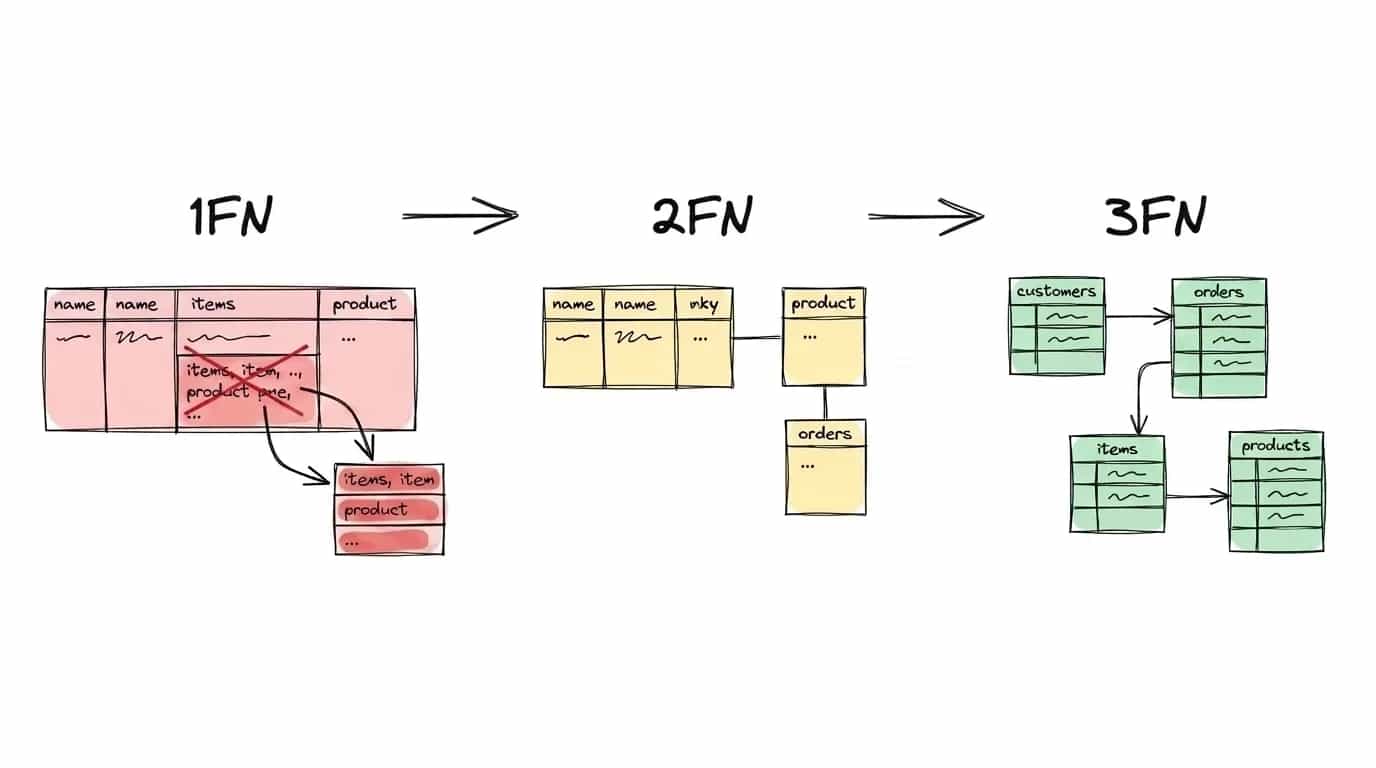
De una sola tabla cajón de sastre han salido cuatro tablas relacionadas. Puedes explorar el esquema en vivo:
Veamos qué ha sido de las anomalías: el teléfono de Ana se cambia en un solo sitio; borrar un pedido no toca al cliente; un cliente sin pedidos vive tranquilamente en customers; y las ventas de cola se cuentan sobre order_items sin ningún LIKE.
Cuándo está justificado duplicar: la desnormalización
La normalización no es un fin en sí misma, sino una forma de proteger los datos para que no se desincronicen. A veces uno se aparta de ella a sabiendas:
- Una foto del momento. El precio en products cambia, pero en el ticket de un pedido ya pagado debe quedarse tal como estaba en el momento de la compra. Por eso es habitual añadir una columna price a order_items: no es un error, sino el registro de un hecho histórico.
- Totales ya calculados. El importe del pedido se puede calcular cada vez a partir de sus líneas, pero con miles de consultas por segundo sale más barato guardar total_amount en orders y actualizarlo cuando cambie el contenido.
- Analítica. En los data marts de informes los datos se «vuelven a juntar» a propósito en tablas anchas, para que las consultas no tengan que encadenar una docena de JOIN.
La palabra clave es a sabiendas: desnormalizar siempre significa que la coherencia entre los duplicados pasa a ser responsabilidad de tu código, no del SGBD.
Siguientes pasos
- de qué se compone una buena estructura de tablas, en la lección Estructura de las bases de datos relacionales;
- las claves primarias y foráneas en las que se apoyan las relaciones, en la lección Restricciones;
- al diseño de esquemas «a partir del problema de negocio», incluidas la normalización, la desnormalización y el trabajo con el historial de datos, está dedicado todo un curso: Diseño y arquitectura de bases de datos.